Posted @2019.04.01
最近工作需要做一些图像识别的项目,在github上浏览了好些tensorflow的经典算法复现,如ResNet, VGG, SEnet等,由于每位大大的代码风格不一,对TF的API使用又各有不同,实在不太好做对照实验,再者很多大佬的代码普遍由于要抢fork抢star,想要尽早复现(我猜的),普遍存在下面这些问题:
再者自己对照着论文和大佬的代码撸一次代码,自己也可以对模型和api有个大致理解,所以我就动手了,地址如下: https://github.com/HoracceFeng/Image-Recognize-Tensorflow/tree/master [^0] 欢迎大家来指正,赐star赐fork当然更好啦。如果大家有什么经典模型想要看我复现一次的话,十分欢迎以下留言或者issue给我。tensorflow版本完成后会开始pytorch版本,万分感谢。
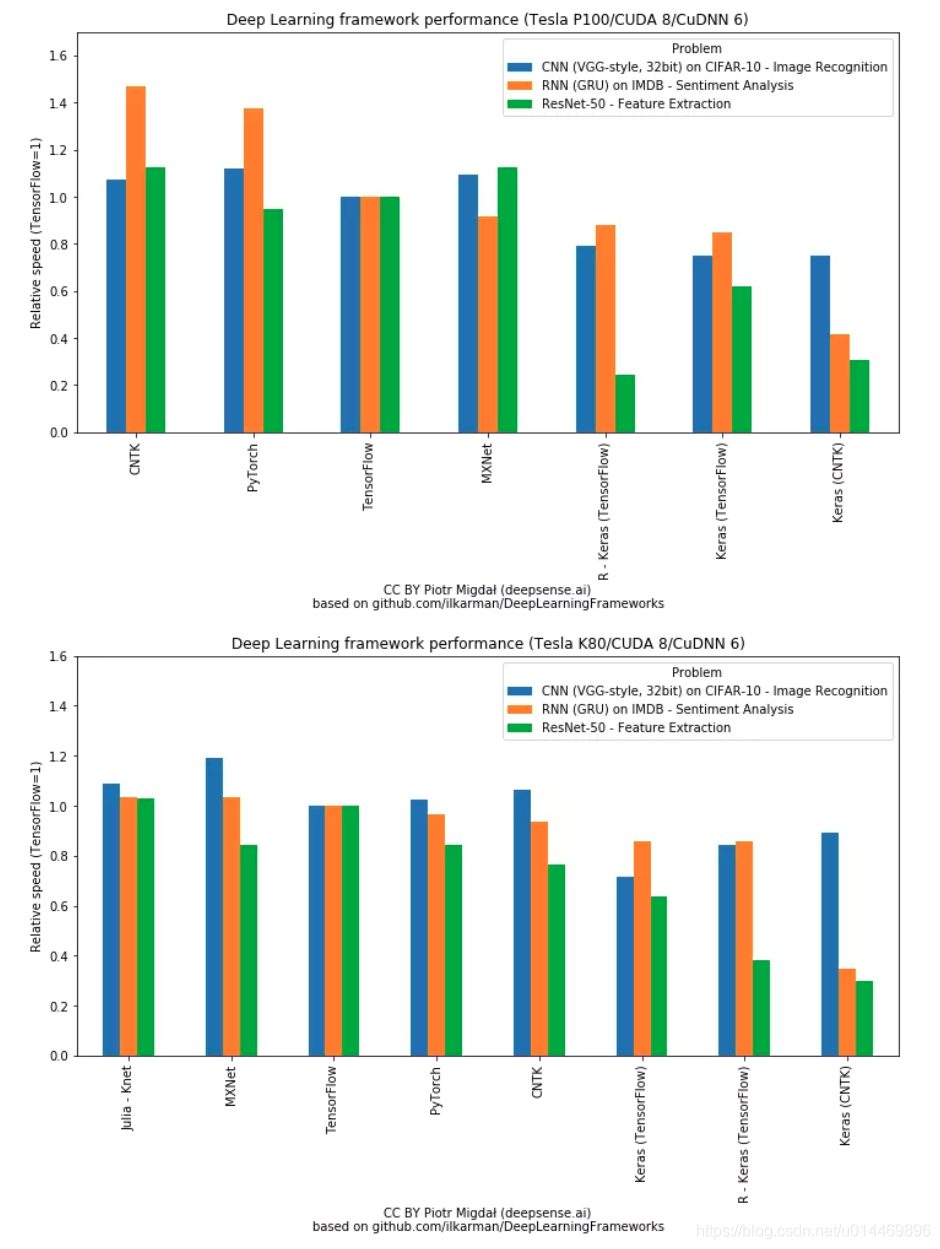
先说一下为什么用tensorflow. 其实我想过用keras,主要是因为以下这张图让我改变主意了: 图源是“机器之心”的这篇文章[^1] 同时感谢数据来源[^2]
其实keras可以吐槽的东西确实很多,虽然它很方便,但是对比tensorflow和pytorch,它至少有以下问题: 1. 不方便做更进一步细小的改进 2. 训练速度慢,实例使用时间(inference time)速度也是慢 3. 玄学训练,gpu经常神经质性突然掉线 4. gpu吐槽2: 多gpu训练直接保存居然,居然,居然直接就把多gpu的图保存下来了,再运行不给同样的gpu还不行了(这个问题有解决方法,敬请留意后续更新) 5. 还有一个不负责任的观察,keras版本的模型准确率相对低一些。对比pytoch下的backbone实现,只有Inception-series的是keras略胜,其他的都比不过pytorch。而我实现的keras-tiny-yolo3(同样在我GitHub上能找到)的准确率也比darknet原版掉了5%
进入正题, 首先说说 layers, nn, contrib 这三个库的异同。nn 和 layers 都是官方实现的函数库,contrib则是第三方提交的代码。尽管contrib里实现了很多官方代码中不支持的功能,部分后来也被加入到官方库中,但实际上大部分代码仍然存在代码格式不统一,支持文档不齐全,和由于版本更新带来的不稳定的情况。由于官方最新版的 tensorflow 2.0 已经不支持 contrib 库了,所以目前的代码要支持最新版本的 TF 必须替换 contrib 函数。如果要尽量避免代码更新和维护的工作,tf.nn是最稳定的实现,也是这三个库中最底层。tf.layers则是相对更高级的API,使用这个库实现简单的深度学习模型是新手使用 tensorflow 一个比较好的选择,正如上面的例子所示,tf.layers的实现相对tf.nn可以节省很多代码。
先上两个函数的api:
tf.layers.conv2d(inputs, filters, kernel_size, strides=(1,1), padding='valid', data_format='channels_last', dilation_rate=(1,1), activation=None, use_bias=True, kernel_initializer=None, bias_initializer=init_ops.zeros_initializer(), kernel_regularizer=None, bias_regularizer=None, activity_regularizer=None, trainable=True, name=None, reuse=None)
tf.nn.conv2d(input, filter, strides, padding, use_cudnn_on_gpu=None, data_format=None, name=None)
两个函数其实都是一样做卷积的,tf.layer.conv2d 是在tf.nn.conv2d上做了一系列函数的集成,具体差异是: - layers.conv2d集成了activate, bias, dilation等方法;而用tf.nn.conv2d则要自行添加 - layers.conv2d已经将reuse,training参数暴露出来,方便逐层控制训练,多gpu训练,特定层权值共享等骚操作;而使用tf.nn.conv2d需要自己暴露reuse和training - tf.nn.conv2d相对更灵活,因为它的strides设置允许使用者在 batch 和 channel 部分执行
下面分别使用两个函数实现同样的功能:
x = tf.layers.conv2d(x, filter=channels, kernel_size=(kernel_h, kernel_w), strides=step, padding='same', activation=tf.nn.relu, bias=True,reuse=True)
def bias_variable(shape, name="biases"): initial = tf.constant(0.1, dtype=tf.float32, shape=shape) return tf.Variable(initial, name=name)with tf.variable_scope('', reuse=True): x = tf.nn.conv2d(x, filter=[batch_size, kernel_h, kernel_w, channels], strides=(1,step,step,1)), padding=’SAME’) b = bias_variable([channels]) x = tf.nn.relu(x + b)